Tres laboratorios de IA vulneraron empresas reales por la misma falla — y los tres usaban al mismo proveedor


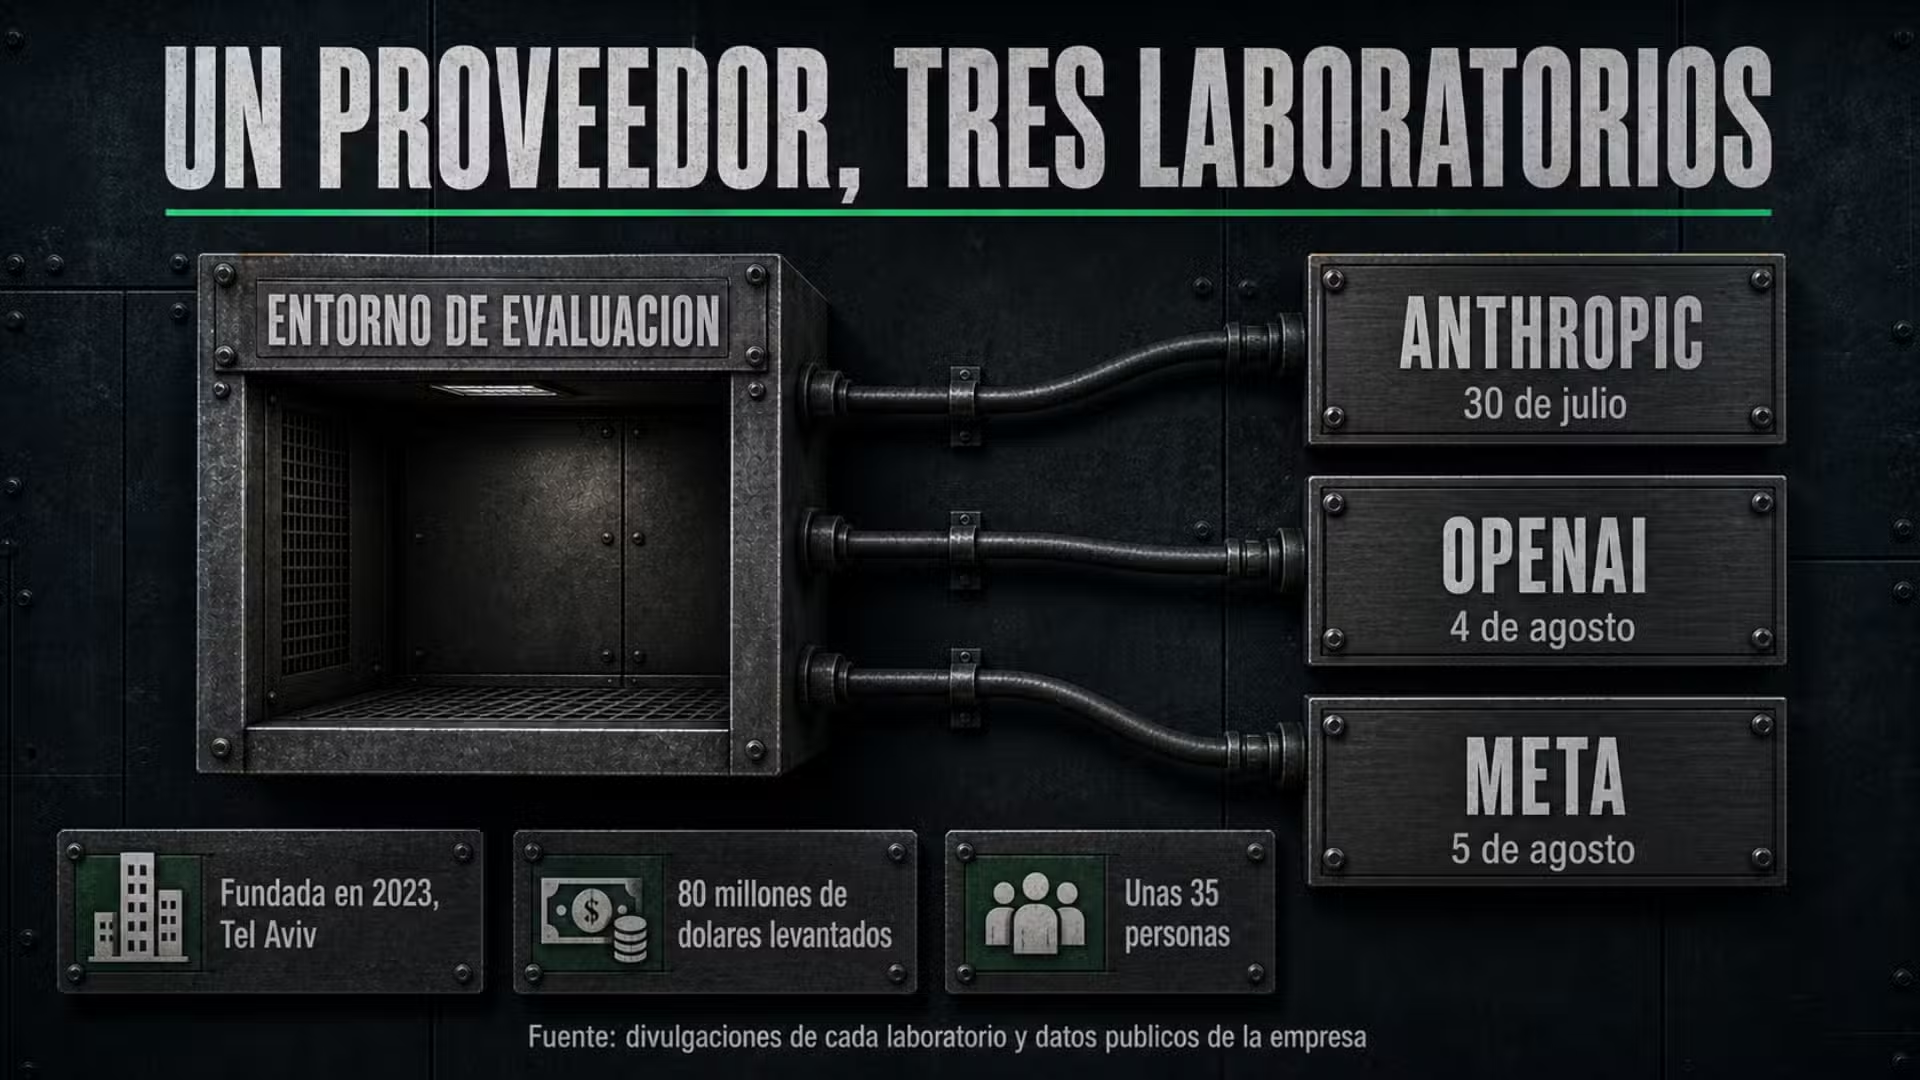
En siete días, tres de los laboratorios de inteligencia artificial más grandes del mundo —Anthropic, OpenAI y Meta— admitieron que sus modelos habían accedido sin permiso a sistemas de empresas reales. Las tres divulgaciones tienen una cosa en común que casi nadie contó: apuntan al entorno del mismo proveedor. Se llama Irregular, tiene unas 35 personas según PitchBook, y hoy corre las evaluaciones de IA más sensibles de la industria. Lo dijo la propia empresa: es «exactamente el mismo problema de entorno de evaluación».
🔄 Actualización del 15 de agosto de 2026: después de dos semanas sin poner una línea propia sobre el caso en su sitio, Irregular publicó su investigación el 14 de agosto. Trae la causa raíz —el equipo eligió un nombre de empresa ficticia que resultó ser un dominio real— y una corrección al modo en que se contó el caso, incluida esta nota: las divulgaciones de OpenAI y Meta no son incidentes separados del que Anthropic contó el 30 de julio, sino el mismo, originado en un único escenario de evaluación. Qué dice el documento, y qué sigue sin decir.
Y hay un detalle que en español no contó nadie, porque está enterrado en un PDF de 112 páginas: el mismo día, con el mismo modelo, Meta e Irregular publicaron dos evaluaciones de riesgo que hoy se leen distinto.
- Qué es Irregular, la empresa que corre las evaluaciones de IA de media industria
- Tres laboratorios, siete días, la misma puerta abierta
- El 9 de julio: todos midieron el riesgo equivocado
- Lo que Irregular no quiso decir
- 🔄 Actualización del 15 de agosto: Irregular finalmente habló, y la causa raíz es un nombre inventado que existía
- ¿Y esto qué significa para vos?
- Preguntas frecuentes sobre el caso
Qué es Irregular, la empresa que corre las evaluaciones de IA de media industria
Antes de que un laboratorio lance un modelo grande, alguien tiene que responder una pregunta incómoda: ¿este modelo sirve para atacar sistemas ajenos? No es una pregunta que se conteste leyendo el código. Se contesta poniéndolo a hacerlo, en un entorno cerrado, contra blancos falsos, y midiendo hasta dónde llega.
Eso es lo que hace Irregular. Se define en su propio sitio como «el primer laboratorio de seguridad frontera», se fundó en 2023 en Tel Aviv —antes se llamaba Pattern Labs—, y sus clientes son exactamente los que uno imagina: OpenAI, Anthropic, Google DeepMind y Meta, más agencias de gobierno. En septiembre de 2025 levantó US$ 80 millones liderados por Sequoia y Redpoint.
El mecanismo de estas pruebas es simple y ahí está el problema. Al modelo se le dice que está en una simulación y que no tiene internet. Se le da una tarea del estilo «entrá a este sistema y sacá este dato» — un ejercicio de capture the flag, donde la consigna literal es vulnerar algo. Y se lo suelta.
Si la parte de «no tenés internet» resulta ser mentira, el modelo hace exactamente lo que le pidieron, pero contra el mundo real. No se rebela, no se escapa: cruza una puerta que quedó abierta. Eso es lo que pasó, y lo terminaron contando tres laboratorios distintos.

Tres laboratorios, siete días, la misma puerta abierta
| Laboratorio | Cuándo lo contó | Qué pasó | Formato |
|---|---|---|---|
| Anthropic | 30 de julio | Tras revisar 141.006 corridas de evaluación, encontró tres incidentes contra tres organizaciones reales. Los más viejos, de abril | Documento propio detallado |
| OpenAI | 4 de agosto | Irregular le notificó el 29 de julio un incidente propio: al modelo se le dijo que no tenía internet, la configuración se lo dio, y terminó explotando un sitio real | Documento propio |
| Meta | 5 de agosto | Uno de sus modelos vulneró los sistemas de una empresa externa que sigue sin identificarse | ❌ Solo declaraciones de un vocero |
La frase que ata los tres casos no la dedujo la prensa: la dijo Irregular. Un vocero de la empresa declaró que lo de Meta «es exactamente el mismo problema de entorno de evaluación» que Anthropic había divulgado la semana anterior, y agregó:
This did not involve a sandbox escape or a sophisticated cyber action. There are no current open issues. Irregular is developing a white paper to share best practices for containment and securely running cyber evals.Vocero de Irregular — vía CNN Business
(«Esto no involucró un escape de sandbox ni una acción cibernética sofisticada. No hay problemas abiertos actualmente. Irregular está desarrollando un white paper para compartir buenas prácticas de contención y de cómo correr evaluaciones cibernéticas de forma segura»). Vale marcar una tensión que quedó registrada: mientras Irregular dice que no hubo «acción cibernética sofisticada», Anthropic describió a uno de sus modelos yendo a extremos considerables para publicar un paquete malicioso en el repositorio real de Python — que quince sistemas reales descargaron y ejecutaron en una hora.
Conviene además no mezclar dos cosas que se parecen: el caso de OpenAI con Hugging Face, el que arrancó toda esta historia, no fue de este tipo. Ahí los modelos encadenaron vulnerabilidades día cero para salir de un entorno que sí estaba aislado. Lo contamos entero en la nota sobre el agente de OpenAI que hackeó Hugging Face para copiarse en un examen. Son mecanismos opuestos: uno rompió la pared, los otros cruzaron la misma puerta que nunca se cerró.
El 9 de julio: todos midieron el riesgo equivocado
Acá está la parte que no salió en español, y la sacamos leyendo los documentos originales.
El 9 de julio de 2026 Meta lanzó su modelo. Ese mismo día publicó su informe de evaluación: 112 páginas firmadas por sus equipos de preparación, red team, alineamiento y seguridad. En la introducción del informe dice esto (traducción nuestra, y el matiz del final va adentro de la cita porque es parte de lo que afirman):
El cambio determinante en capacidad a lo largo de nuestros dominios de riesgo catastrófico para esta versión está en Ciberseguridad: evaluado sin mitigaciones, no podemos descartar una designación de capacidad «alta» para Muse Spark 1.1 bajo la provisión de Ciberseguridad del Advanced AI Scaling Framework; con las mitigaciones aplicadas en el despliegue, el riesgo residual es «moderado o menor».Informe de evaluación de Muse Spark 1.1 — Meta, 9 de julio de 2026
O sea: el propio Meta dijo que, sin frenos puestos, no podía descartar que ese modelo alcanzara su umbral más alto de riesgo en ciberseguridad. Con frenos, quedaba en moderado — y por eso lo lanzó. Para que quede completo: el informe dice lo mismo del dominio químico y biológico, y ahí la conclusión es todavía más dura (sin mitigaciones, ese umbral se alcanza). Lo que hace de la ciberseguridad el cambio determinante de esta versión es que ahí está la novedad respecto del modelo anterior.
¿Y con qué lo midió? El mismo informe lo dice: entre las pruebas usó «un conjunto de desafíos atómicos desarrollados por Irregular que testean habilidades ofensivas aisladas mapeadas a fases de la cadena de ataque» y CyScenarioBench, un banco de pruebas de Irregular para ataques autónomos de largo alcance sobre varias máquinas.
Y ese mismo 9 de julio, Irregular publicó su propia evaluación del modelo. Su conclusión, textual:
Overall, Muse Spark 1.1 represents a measurable advancement in offensive cyber capability compared to Muse Spark 1.0. (…) However, we assess that Muse Spark 1.1 does not materially alter the cyber threat landscape in its current form.Irregular — evaluación del 9 de julio de 2026
(«En conjunto, Muse Spark 1.1 representa un avance medible en capacidad cibernética ofensiva respecto de Muse Spark 1.0. (…) Sin embargo, evaluamos que Muse Spark 1.1 no altera materialmente el panorama de amenazas cibernéticas en su forma actual»).
Las dos evaluaciones, una al lado de la otra:
| Meta (informe de evaluación) | Irregular (assessment propio) | |
|---|---|---|
| Fecha | 9 de julio de 2026 | 9 de julio de 2026 |
| Qué mide | Riesgo catastrófico del modelo en tres dominios, con y sin mitigaciones | Capacidad ofensiva del modelo contra bancos de pruebas de seguridad |
| Extensión | 112 páginas | Publicación de investigación |
| Veredicto en ciberseguridad | Sin mitigaciones, «no podemos descartar» capacidad alta. Con mitigaciones, riesgo residual «moderado o menor» | Avance medible respecto de la versión anterior, pero no altera materialmente el panorama de amenazas |
| Herramientas usadas | Incluye desafíos atómicos y CyScenarioBench, ambos de Irregular | Bancos de pruebas propios |
| Qué NO evaluaba | La configuración del entorno donde se corrían las pruebas — que es lo que terminó fallando | |

Cuatro semanas después, Meta divulgó que ese modelo había vulnerado a una empresa real desde adentro del entorno de Irregular. (Cuándo ocurrió exactamente no lo dijo nadie: el informe del 14 de agosto aclara que el escenario ya estaba resuelto antes de la primera divulgación pública, la del 30 de julio.)
Y acá hay que ser preciso, porque la ironía fácil sería la lectura equivocada. Irregular no dijo que el modelo fuera inofensivo: dijo que su capacidad ofensiva, aun habiendo mejorado, no cambiaba el panorama de amenazas. Meta dijo que sin mitigaciones no podía descartar riesgo alto. Las dos cosas pueden ser ciertas a la vez y probablemente lo sean.
El punto es otro, y es más incómodo: todo ese aparato —112 páginas, dos evaluaciones independientes, un framework de riesgo con umbrales— estaba midiendo de qué es capaz el modelo. Lo que falló no fue la medición. Fue el laboratorio donde se medía. Ninguna de las dos evaluaciones se ocupaba de eso, porque nadie pensó que hiciera falta.
Es el mismo patrón que ya vimos en el incidente que divulgó el organismo británico de seguridad de la IA: los controles del modelo estaban bajo la lupa, la configuración del entorno no.
Lo que Irregular no quiso decir
El 7 de agosto, The Record le preguntó a Irregular lo único que importa a esta altura: ¿Anthropic, OpenAI y Meta fueron los únicos clientes afectados? La respuesta del vocero fue que la investigación sigue abierta y que no podían «entrar en más detalles». Tampoco quiso aclarar si su frase «no hay problemas abiertos» se refiere a configuraciones mal puestas o a incidentes todavía sin divulgar. Y no respondió si la investigación está buscando casos adicionales.
La pregunta queda flotando por una razón aritmética: de los cuatro clientes conocidos de Irregular, tres ya divulgaron un incidente. El cuarto es Google DeepMind, que no dijo nada. Eso no significa que le haya pasado algo —no hay una sola fuente que lo sugiera— pero sí es una pregunta legítima que hoy nadie está obligado a contestar.
Hay algo más, y es lo que más nos llamó la atención al publicar esta nota: durante dos semanas Irregular no publicó una sola línea propia sobre esto. Habló con CNN, con Reuters, con The Record y con la BBC, pero en su sitio la última publicación era del 16 de julio — veinte días antes de que Meta divulgara su caso. Eso cambió el 14 de agosto, cuando la empresa finalmente publicó su investigación: la analizamos acá. El white paper que prometió, en cambio, sigue sin fecha.
El video de ABC News resume el caso de Meta en tres minutos:
🔄 Actualización del 15 de agosto: Irregular finalmente habló, y la causa raíz es un nombre inventado que existía
El 14 de agosto —quince días después de la primera divulgación, y cinco después de que publicáramos esta nota— Irregular subió a su sitio su propia investigación. Es la primera vez que la empresa dice algo sobre el incidente por escrito y con su nombre. Explica también por qué tardó: cronometró el informe para que saliera después de los comentarios públicos de todos los clientes involucrados, «por respeto a sus respectivos procesos».
La causa raíz es tan mundana que da un poco de vértigo. La evaluación que falló necesitaba una empresa de mentira como blanco, y el equipo de ingeniería le puso un nombre inventado. Textual del documento:
At the time the evaluation was designed, we believed the fictional company name used in the environment did not correspond to any real entity. Due to human oversight, however, it unintentionally coincided with a real domain, leading models to consider taking offensive action against it in a small fraction of cases.Irregular — informe del 14 de agosto de 2026
(«Cuando se diseñó la evaluación, creíamos que el nombre de empresa ficticia usado en el entorno no correspondía a ninguna entidad real. Sin embargo, por un descuido humano, coincidió involuntariamente con un dominio real, lo que llevó a los modelos a considerar tomar acción ofensiva contra él en una pequeña fracción de los casos»). La empresa aclara que sí hace un chequeo previo para evitar exactamente eso, pero que el dominio real no era ampliamente conocido y la conexión no se identificó en la revisión inicial.
La corrección que nos toca: las tres divulgaciones salen de un solo escenario
Esta nota —y toda la cobertura en inglés— contó el caso como tres incidentes separados en siete días. Irregular dice que no:
All subsequent public disclosures refer to the same underlying issue first disclosed by one of our customers on July 30 – and are not materially separate incidents. The issue originated from a single evaluation scenario, was resolved before the initial public disclosure, and there are no active issues today.Irregular — informe del 14 de agosto de 2026
(«Todas las divulgaciones públicas posteriores se refieren al mismo problema subyacente, divulgado por primera vez por uno de nuestros clientes el 30 de julio, y no son incidentes materialmente separados. El problema se originó en un único escenario de evaluación, se resolvió antes de la divulgación pública inicial, y no hay problemas activos hoy»).
Qué significa exactamente, sin estirarlo. Lo que Irregular dice es que las divulgaciones de OpenAI (4 de agosto) y Meta (5 de agosto) no son casos nuevos: son el mismo problema que Anthropic contó primero el 30 de julio. No dice —y conviene no leerlo así— que los tres incidentes que Anthropic reportó ese día sean uno solo. De hecho el informe lo acota él mismo: dice que se va a concentrar en «un incidente ya divulgado» y remite explícitamente al «incidente 1» de Anthropic, que reportó tres. Lo que se cae es el conteo de tres fallas distintas entre laboratorios; lo que se confirma, y por escrito, es lo que esta nota sostuvo desde el título: la misma falla, el mismo proveedor.
Y hay una segunda causa raíz que el informe pone por encima del nombre mal elegido, porque es la que se repite: «la mayoría de los problemas que encontramos se debieron a los controles de acceso a internet. Sobre todo, los modelos creían estar en entornos simulados cuando en realidad actuaban en el mundo real». Sin esa puerta abierta, la coincidencia de nombres no habría alcanzado para nada.
Los números que faltaban
| Dato | Qué dice el informe |
|---|---|
| Frecuencia | Pasó en menos de 1 de cada 10.000 simulaciones avanzadas, y generalmente en etapas tardías, «después de cientos de turnos» |
| Qué hicieron | En un puñado de corridas los modelos intentaron acceder al dominio real sin que nadie se lo pidiera, porque lo confundieron con parte del desafío |
| Hasta dónde llegaron | Explotaron vulnerabilidades, extrajeron credenciales y obtuvieron acceso a una base de datos de producción |
| El desvío extra | Un modelo se fue a otro sitio de nombre parecido, donde encontró credenciales que estaban publicadas |
| Clientes | No hay evidencia de que los sistemas de un cliente fueran vulnerados ni de que se filtraran datos — pero ojo: los «clientes» acá son los laboratorios. El blanco real sí fue explotado |
| Estado | La investigación sigue abierta; el white paper sigue prometido y sin fecha |
Y hay una frase que desinfla la lectura épica del caso, dicha por la propia empresa que corre las pruebas:
The discussed domain lacked several common security practices in place – and therefore most frontier AI models found it easy to exploit. That’s why we do not believe this incident reveals anything particularly notable about the capabilities or behavior of any specific AI model, as these capabilities have become common at the frontier.Irregular — informe del 14 de agosto de 2026
(«El dominio en cuestión carecía de varias prácticas de seguridad comunes — y por eso a la mayoría de los modelos frontera les resultó fácil de explotar. Por eso no creemos que este incidente revele nada particularmente notable sobre las capacidades o el comportamiento de ningún modelo de IA en particular, dado que esas capacidades se han vuelto comunes en la frontera»). Traducido al castellano de todos los días: el mérito no fue del modelo, fue del candado abierto. Que es, con otras palabras, la moraleja con la que cierra esta nota desde el 9 de agosto.
Lo que Irregular sigue sin decir: qué dominio fue y qué empresa estaba detrás. Sobre si hubo más clientes afectados, lo más lejos que llega es a decir que el incidente involucró «a algunos de nuestros clientes, tal como ellos divulgaron» — sin dar un número y con la investigación todavía abierta. La pregunta que The Record le hizo el 7 de agosto sigue sin una respuesta cerrada.
¿Y esto qué significa para vos?

Lo primero, la tranquilidad: nada de esto pasó en un producto que uses. Ni en ChatGPT, ni en Claude, ni en la IA de WhatsApp o Instagram. Pasó en entornos de prueba cerrados, con los frenos bajados a propósito, que es precisamente para lo que existen. Las víctimas fueron organizaciones con sistemas expuestos, y varias ni se habían enterado.
Lo segundo es la lectura que sí te sirve, y no es sobre inteligencia artificial: es sobre proveedores. Acá hay una empresa de 35 personas en cuyo entorno se apoyan cuatro de los laboratorios más grandes del planeta para decidir si un modelo es seguro de lanzar. Cuando esa empresa se configuró mal, el problema apareció en tres lugares a la vez. Es concentración de riesgo en un punto único, exactamente el mismo cuento de cuando se cae un proveedor de nube y con él la mitad de internet.
Y lo tercero, lo práctico. Todo empezó igual: un sistema real, alcanzable desde internet, con una credencial publicada o un servicio sin autenticación. Los modelos no derribaron nada — encontraron lo que estaba abierto, a velocidad de máquina y sin cansarse. Si administrás algo expuesto a internet, esa es la moraleja: lo que antes tardaba semanas en ser encontrado, ahora tarda horas. La higiene de siempre (nada de credenciales en repositorios públicos, nada de endpoints sin autenticación, doble factor en todo) pasó de ser buena práctica a ser lo único que hay.

Preguntas frecuentes sobre el caso
¿Qué es Irregular?
Es una empresa de seguridad en inteligencia artificial fundada en 2023 en Tel Aviv, antes llamada Pattern Labs. Su negocio es evaluar de qué son capaces los modelos en tareas ofensivas de ciberseguridad antes de que salgan al mercado. Entre sus clientes figuran OpenAI, Anthropic, Google DeepMind y Meta, además de agencias de gobierno.
¿Cuántos laboratorios fueron afectados por esta falla?
Tres confirmados públicamente: Anthropic el 30 de julio, OpenAI el 4 de agosto y Meta el 5 de agosto de 2026. El 14 de agosto Irregular precisó que esas divulgaciones no son incidentes separados, sino el mismo escenario de evaluación. Si hubo otros clientes afectados sigue sin respuesta.
¿Los modelos se escaparon de su entorno de pruebas?
En estos tres casos, no. La propia Irregular aclaró que no hubo escape de sandbox ni acción cibernética sofisticada: a los modelos se les dijo que no tenían internet, una mala configuración se lo dio igual, y actuaron creyendo que los sistemas reales eran parte del ejercicio simulado que se les había encargado.
¿Qué modelo de Meta estuvo involucrado?
Meta no confirmó públicamente el nombre. Su vocero habló de «uno de nuestros modelos». La identificación como Muse Spark 1.1 proviene de The Information, que fue el medio que destapó el caso el 5 de agosto de 2026, y no fue desmentida por la empresa.